

01 论文速览
期刊:Construction and Building Materials 题目:A cellular automata method driven by environmental and material data for simulating atmospheric corrosion evolution of weathering steel 团队:天津大学水利工程智能建造与运维全国重点实验室 链接: https://doi.org/10.1016/j.conbuildmat.2026.147890
02 核心摘要
这篇论文解决一个很实际的工程问题:耐候钢的大气暴露试验又慢又贵,而现有方法没法逼真地复现腐蚀演化。作者搭了一个"环境+材料数据驱动"的元胞自动机(CA)方法,把机器学习预测、机理仿真、参数反演三步串成一条链:先用 CNN-Attention 网络预测目标环境下的腐蚀损失,再把预测值当约束,用粒子群优化(PSO)反推出 CA 模型的关键参数,最后拿标定好的 CA 跑腐蚀演化。用捷克和斯洛伐克三个城市 10 年的耐候钢暴露数据验证,腐蚀损失 RMSE 落在 3.66 到 5.24 微米之间,表面形貌和点蚀深度分布都对得上,力学性能的最大误差只有 1.85%。
03 具象锚点与研究动机
现实痛点:耐候钢靠早期生成的致密锈层保护基体,可以免涂装直接用在桥梁、输电塔上。但腐蚀直接决定结构剩余寿命,工程上常用"腐蚀损失"(厚度减薄量)来评估。问题在于,厚度损失本身是个平均数,掩盖了局部点蚀带来的应力集中,而应力集中会显著拉低疲劳寿命。
科学问题与作者入口:要刻画点蚀,就得模拟表面形貌。CA 是干这个的利器:把空间切成网格,每个格子(元胞)有有限状态,按局部规则一步步演化。但传统 CA 模型的参数得靠加速腐蚀试验来定,而现实中没有任何一种加速试验能精确复现真实大气环境。作者盯上的就是这个断点:能不能不靠长期暴露数据,也能把某个牌号耐候钢在特定大气环境下的腐蚀演化算出来。入口是用机器学习先"猜"出目标环境的腐蚀损失,再用这个预测值反向标定 CA 参数,等于把"数据驱动"和"机理仿真"接在了一起。
04 核心方法与设计哲学
方法分三层,逻辑是一环扣一环的。
第一层,机器学习预测腐蚀损失:数据来自中国腐蚀与防护网的数据管理系统,覆盖 7 个典型气候试验站、24 个钢种、最长 16 年的暴露,共 698 组数据。输入是环境因子(温度、湿度、降雨、雨水 pH、氯离子和二氧化硫沉积率)、材料成分和暴露时间,输出是厚度损失。作者选了之前表现最好的 CNN-Attention 模型(CBAM 注意力模块,通道注意力和空间注意力串联),训练 100 个 epoch。
第二层,CA 机理仿真:模型里有四类元胞。溶液元胞 W(电解质)、腐蚀元胞 O(氧气和二氧化硫)、金属元胞 M(铁铜铬)、产物元胞 P(锈层)。核心演化规则三条:O 的扩散(随机游走,服从 Fick 第二定律)、O 与 M 的反应(以概率 p 溶解金属,或以 1−p 生成锈层产物)、P 在重力下的沉积。整条腐蚀链被粗粒化成一句 W + O + M → P。元胞间距取 100 微米,前 10 个时间步对应一年。
第三层,PSO 反演标定:真正要标定的只有两个参数:腐蚀元胞浓度 cO 和金属溶解概率 pM。以 ML 预测值和 CA 模拟值之间的 RMSE 作目标函数,用粒子群优化去迭代这两个参数,直到 CA 的腐蚀损失曲线逼近 ML 的预测曲线。图8 就是这一整套 ML-PSO-CA 标定流程。
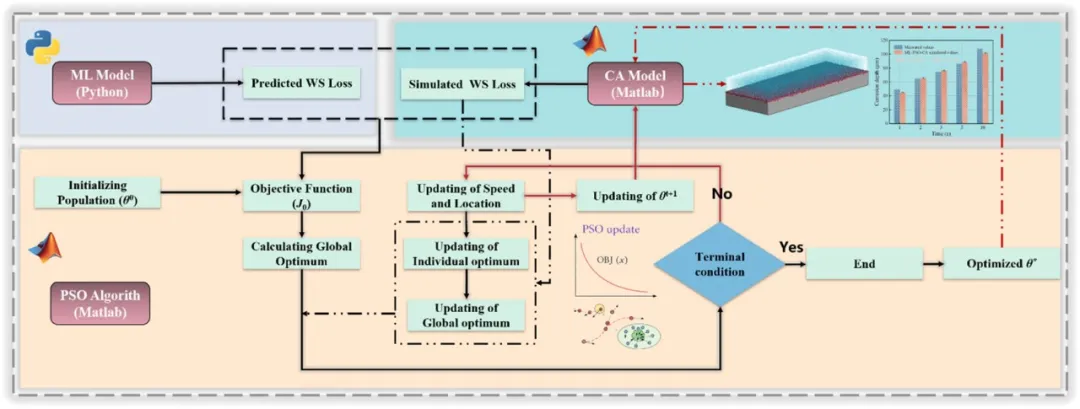
图8:ML-PSO-CA 参数标定流程。机器学习先预测腐蚀损失,作为约束反推元胞自动机的两个关键参数。
05 关键数据与实验结果
验证用的是捷克和斯洛伐克三个站点的 ATMOFIX 52 A 耐候钢 10 年暴露数据,三个站点分别是 Hurbanovo、Praha(城市大气)和 Ústí n. L.(工业大气,SO2 沉积率最高,达到 1.277 mg/100cm²·d)。
先看腐蚀损失。每个标定工况用不同随机种子独立重复 20 次,取均值对比实测值。图9 里误差棒很窄,说明 CA 的随机性对结果影响有限。三个站点的 RMSE 最低 3.66、最高 5.24 微米,MAE 最低 3.10、最高 4.65 微米,模拟值和实测值总体吻合。值得注意的是,Ústí n. L. 的溶解概率标定到了 0.243,远高于另外两个站点的 0.05,正好对应它更高的污染浓度和更快的腐蚀速率,说明参数是跟着环境走的。
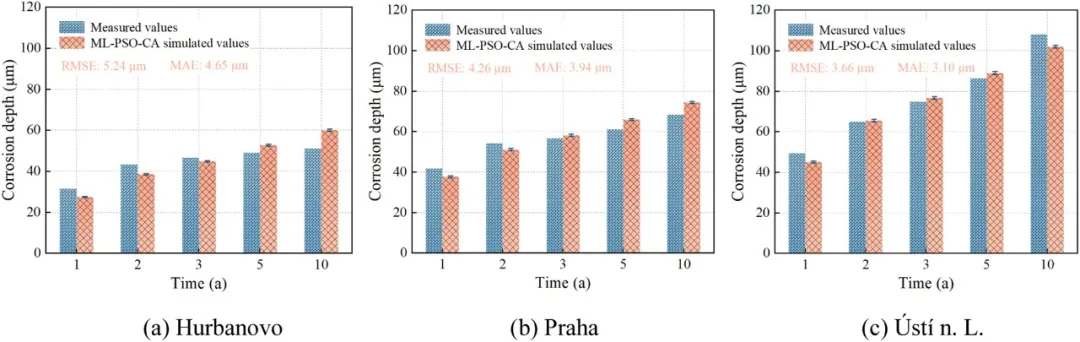
图9:三个站点模拟与实测厚度损失对比。误差棒为 20 次重复仿真的标准差。
再看表面形貌。图10 以 Ústí n. L. 为例,早期点蚀在表面均匀萌生,随暴露时间增加,相邻点蚀逐渐合并,面积和深度同步增大,点蚀从初始的椭圆形态演变成菱形。作者拿它和韩国光阳工业大气环境 10 年暴露的真实图像比对,模拟形貌和真实腐蚀纹理非常接近。
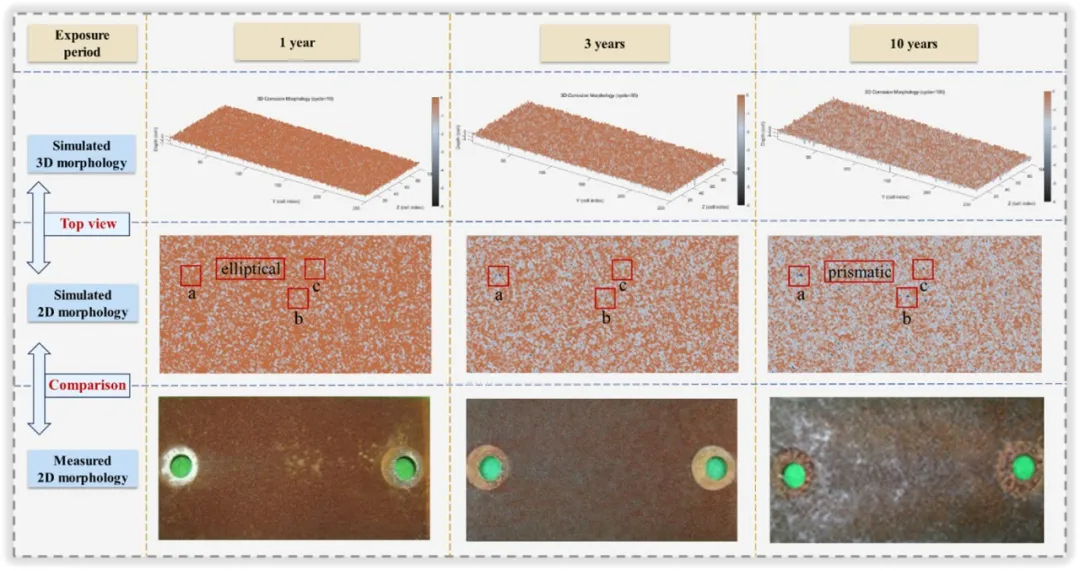
图10:不同暴露年限下的模拟表面形貌。随年限增加,点蚀合并、加深,形态由椭圆转菱形。
点蚀深度分布决定腐蚀类型。图12 里,暴露 1 年最大深度 4 个元胞(400 微米),到 10 年最大深度增长到 6 个元胞(600 微米),且深度 1 个元胞的浅坑占比下降。作者用 Weibull 分布拟合深度分布,拟合曲线和仿真结果吻合良好,这一步把"随机腐蚀"落到了可量化的统计分布上。
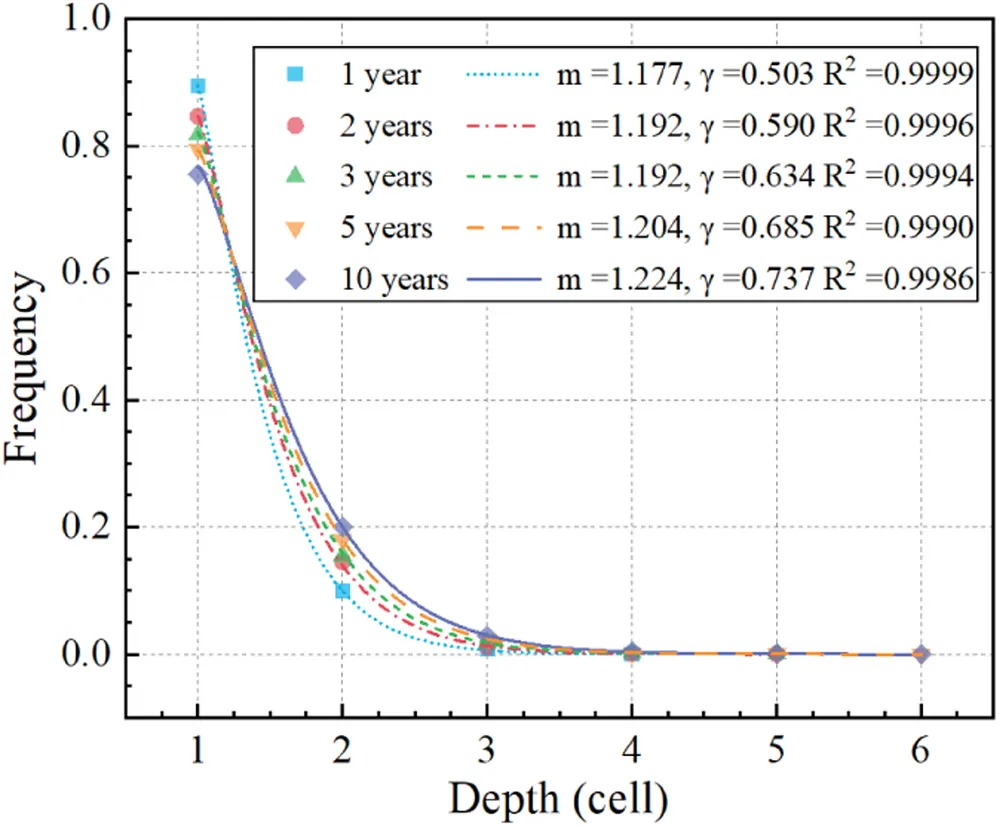
图12:点蚀深度分布及 Weibull 拟合。10 年最大深度达 600 微米。
最后是力学性能。作者把 CA 生成的腐蚀形貌转成有限元模型(MATLAB 提取高度场 → STL → Rhino 转 NURBS → ABAQUS),做拉伸仿真。图15 里极限抗拉强度的最大误差只有 1.85%,而且模拟值普遍略低于实测值,作者把这归因于建模时对尖锐点蚀做了钝化处理。图16 的应力云图显示,随暴露时间增加,点蚀底部的应力集中越来越明显,这正是点蚀腐蚀真正危险的地方。
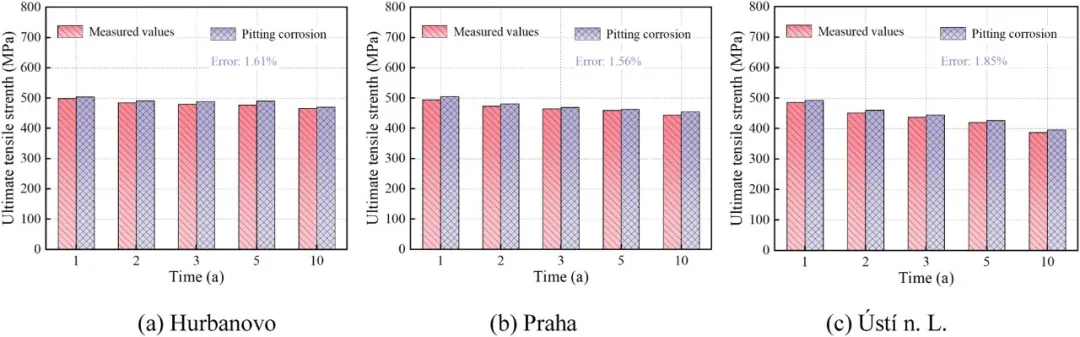
图15:模拟与实测极限抗拉强度对比,最大误差 1.85%。
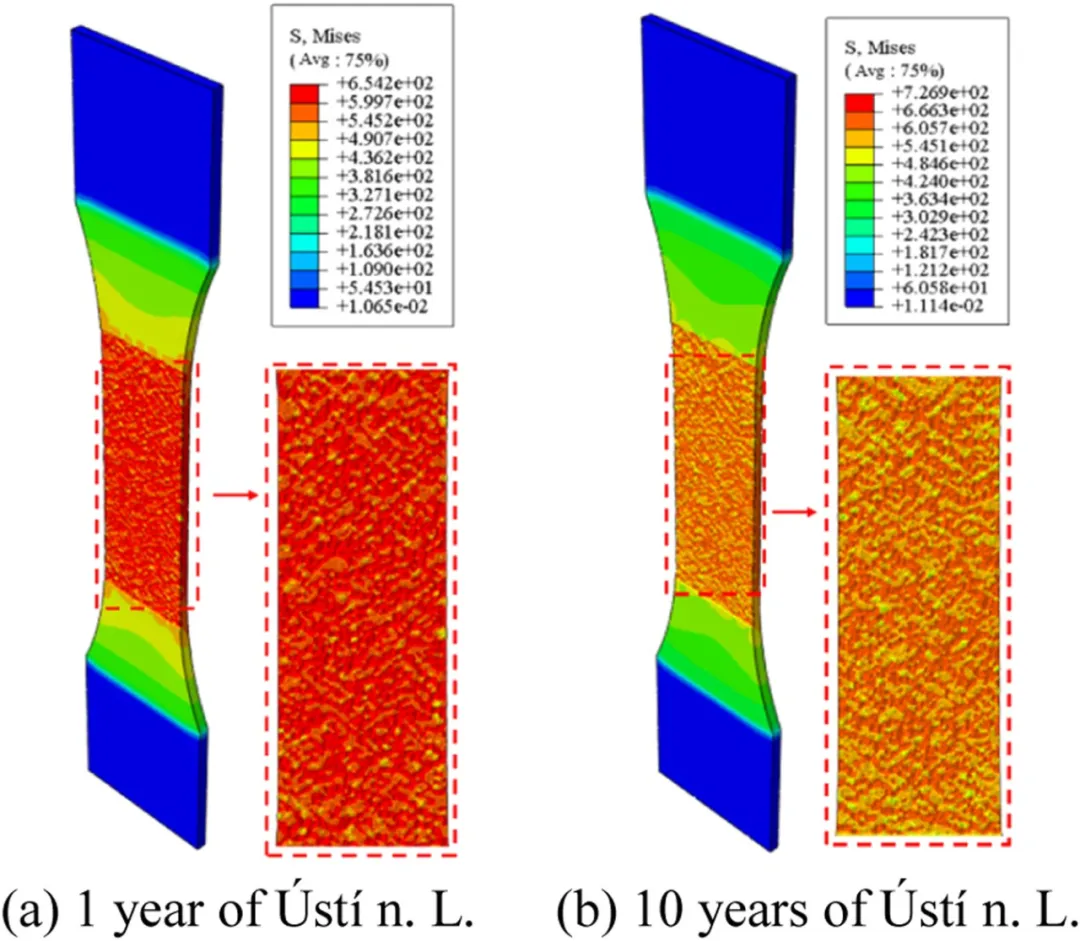
图16:拉伸后的 Mises 应力分布云图。点蚀底部出现明显应力集中。
06 局限性与薄弱点批判
锈层是一笔带过的。作者自己承认,模型把外层锈层和内层锈层统一用一个产物元胞 P 表示,一旦生成就赋予均匀的阻挡效果,没有显式刻画锈层保护性能随时间的演化,也没有体现 Cr、Cu 在界面处的富集和再分布。而锈层的保护性能恰恰是耐候钢区别于普通钢的核心,这个简化牺牲了机理深度。 ML 是整条链的地基,地基晃动全塌。ML 模型的预测精度直接决定 PSO 标定出的参数好坏,进而影响后续仿真。而 ML 本身仍然依赖现有腐蚀数据库训练,在数据稀缺的极端环境里,这条链的前端就站不稳。 验证范围窄。只验证了 ATMOFIX 52 A 一个钢种、三个站点(城市和工业大气)。海洋大气、高氯离子环境没覆盖。作者也承认,缺的是"腐蚀损失+腐蚀后力学性能"的配对长期数据。 点蚀形态的"真实感"没有严格量化。形貌比对是靠视觉相似和 ISO 11463 分类的定性描述,没有给出一个客观的形貌相似度指标。
07 思想结晶与可迁移启发
底层洞见:这篇论文最有价值的地方,不是 CA 本身,而是"用数据反推机理参数"这个桥。过去 CA 参数靠加速试验硬定,这里改成用 ML 预测值当标定靶子,等于把机器学习从"预测器"升级成了"参数标定器"。数据稀缺时,先用可迁移的模型补一个中间量,再让机理模型去对齐这个量,这条思路可以平移到很多"机理模型缺参数"的场景。
实践启发:
计算成本账算得清楚:PSO 标定一次约 10 分钟,标定完的单次 CA 仿真只要 8 秒。把贵的标定和便宜的仿真分开,是工程落地的关键。 20 次重复取均值加误差棒,是处理 CA 这类随机仿真的标配动作,别拿单次结果说事。 从腐蚀形貌一路接到有限元力学分析,这条"形貌 → 结构性能"的链路,是腐蚀数字孪生里最值得补的一环。
08 面试官灵魂 Q&A
Q1:为什么不用纯 CA,非要先套一层机器学习?
A1:CA 的两个关键参数(腐蚀元胞浓度、溶解概率)本身没有物理表可以直接查,传统做法靠加速腐蚀试验反推,但加速试验复现不了真实大气。机器学习的价值是先给出目标环境下一条可靠的腐蚀损失曲线,作为标定的"靶子"。没有这层,CA 参数就是拍脑袋。
Q2:溶解概率 0.243 和 0.05 差这么多,参数会不会过拟合?
A2:这两个值对应的是环境差异:Ústí n. L. 的 SO2 沉积率是 Hurbanovo 的 3.6 倍,溶解概率理应更高。作者用三个站点交叉验证了参数随环境的变化趋势是对的,但本质上每个站点只标定出一组参数,泛化到新环境还依赖 ML 前端的精度,这是整条链的短板。
Q3:这套方法离实际桥梁结构评估还有多远?
A3:方法论已经打通了从腐蚀演化到力学性能评估的链路,误差也控制在可接受范围。缺口在两处:一是验证数据太少,只有单钢种、单批暴露;二是锈层保护性能的机理被简化了。真要上工程,得先补海洋大气、高氯环境的数据,再把锈层演化的细节加回 CA 里。
免责声明:本网站所转载的文字、图片与视频资料版权归原创作者所有,如果涉及侵权,请第一时间联系本网删除。

官方微信
《腐蚀与防护网电子期刊》征订启事
- 投稿联系:编辑部
- 电话:010-62316606
- 邮箱:fsfhzy666@163.com
- 腐蚀与防护网官方QQ群:140808415

“海洋金属”——钛合金在舰船的

腐蚀与“海上丝绸之路”